Agent Analytics와 함께 Fireworks AI 사용
Agent Analytics는 에이전트가 Fireworks AI로 전송하는 모든 요청을 기록하고, 각 대화의 품질에 대해 점수를 매긴 후, 해당 점수를 사용자가 제품에서 수행하는 작업에 결합합니다. Node 및 Python용 Amplitude AI SDK는 Fireworks의 OpenAI 호환 클라이언트를 감싸고 모든 응답에 대해 Fireworks 요청 ID를 캡처합니다. 그런 다음 점수된 세션을 내보내어 사용자가 정의한 품질 기준을 사용하여 Fireworks에서 모델을 트레이닝하거나 미세 조정할 수 있습니다.
에이전트가 Fireworks를 직접 호출할 때 이 페이지를 사용하십시오. Fireworks 트래픽이 OpenRouter 또는 LiteLLM과 같은 다른 게이트웨이를 통해 통과하는 경우, 대신 AI 게이트웨이와 라우터를 사용하십시오.
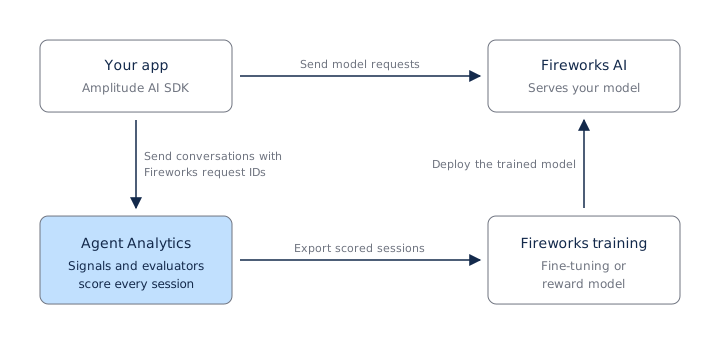
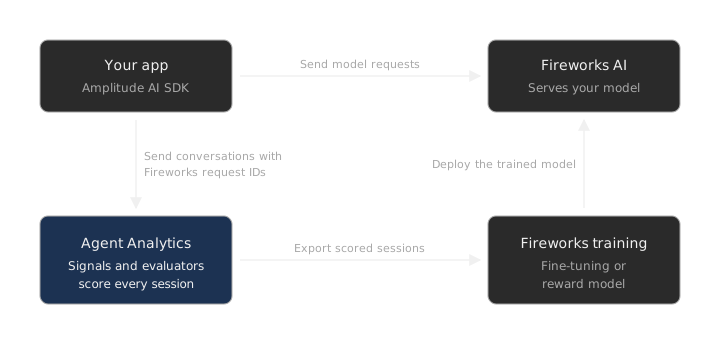
연동은 세 부분으로 구성되며, 순서대로 적용할 수 있습니다.
- Instrument: 각 요청이 사용자, 대화, 에이전트 및 Fireworks 요청 ID와 함께 에이전트 분석에 도달하도록 Fireworks 클라이언트를 AI SDK로 감싸십시오.
- Score: Amplitude의 내장 신호는 모든 종료된 세션에 점수를 부여합니다. 사용자 지정 평가자는 고유한 기준을 추가합니다.
- Export: 점수가 부여된 세션, 추적 및 평가자 결과를 트레이닝 파이프라인에 가져온 다음 Fireworks에서 트레이닝합니다.
AI 코딩 에이전트로 설정(권장)
이 프롬프트를 Cursor, Claude Code, Windsurf, GitHub Copilot 또는 Codex와 같은 AI 코딩 에이전트에 붙여넣으십시오. 에이전트는 AI SDK를 설치하고, 번들로 제공되는 지침을 읽고, 모든 Fireworks 호출을 찾아 계측합니다.
Instrument this app with Amplitude Agent Analytics using the Node SDK. Our model calls go to Fireworks AI.
Also fetch https://raw.githubusercontent.com/amplitude/Amplitude-AI-Node/main/docs/integrations/routers.md
and follow "Path 1: wrap the client" with the Fireworks base URL and the `fireworks` gateway tag.
Install the SDK:
npm install @amplitude/ai @amplitude/analytics-node
Then follow `node_modules/@amplitude/ai/amplitude-ai.md`.
제안되는 변경 사항을 검토한 다음 연동 확인을 사용하여 결과를 확인합니다.
Fireworks 트래픽을 에이전트 분석으로 전송
AI SDK의 래핑된 OpenAI 클라이언트를 Fireworks의 기본 URL로 지정하고 https://api.fireworks.ai/inference/v1각 요청을 에이전트 세션 내에서 실행합니다. 세션은 Fireworks가 모르는 세 가지 사실을 제공합니다. 즉, 사용자가 누구인지, 요청이 속한 대화, 어느 에이전트가 작성했는지와 같은 것입니다. 래핑된 클라이언트는 각 새 사용자 메시지를 추적하므로 수동으로 추적하지 마십시오.
import { AmplitudeAI, OpenAI } from "@amplitude/ai";
const ai = new AmplitudeAI({ apiKey: process.env.AMPLITUDE_AI_API_KEY! });
const fireworks = new OpenAI({
  amplitude: ai,
  apiKey: process.env.FIREWORKS_API_KEY,
  baseUrl: "https://api.fireworks.ai/inference/v1",
});
const agent = ai.agent("support-bot", {
  context: { ingestion_path: "gateway", gateway: "fireworks" },
});
export async function handleChat(
  userId: string,
  sessionId: string,
  messages: { role: "user"; content: string }[],
) {
  return agent.session({ userId, sessionId }).run(async () => {
    const response = await fireworks.chat.completions.create({
      model: "<router or model ID>",
      messages,
    });
    return response.choices[0]?.message.content;
  });
}
SDK는 *.fireworks.ai 기본 URL에서 Fireworks를 감지합니다. 각 [Agent] AI Response 이벤트는 스트리밍 여부에 관계없이 다음을 포함합니다.
| 속성 | 값 |
|---|---|
[Agent] Provider | fireworks |
[Agent] Provider Request ID | 해당 요청에 대한 Fireworks response.id. 이는 점수 또는 내보낸 턴을 하나의 Fireworks 추론에 다시 연결하는 키입니다. |
[Agent] Model Name | 답변한 모델입니다. 라우터의 경우 라우터가 선택한 모델입니다. |
[Agent] Cost USD | 공개 요금 기준 비용. SDK는 -fast라우터와 같은 계층 라우터의 가격을 해당 계층에서, 다른 라우터는 선택한 모델로 가격을 책정합니다. SDK에서 가격을 책정할 수 없는 모델은 $0가 아닌 비용이 발생하지 않습니다. |
[Agent] Context | ingestion_path 및 gateway을(를) 사용하면 Fireworks 트래픽을 차트에서 다른 공급자와 분리할 수 있습니다. |
Fireworks가 자체 프록시 URL 뒤에 있는 경우 SDK는 URL에서 이를 감지할 수 없습니다. Node SDK에서 클라이언트에 provider: 'fireworks'을(를) 설정합니다. SDK는 Fireworks의 x-multi-turn-session-id 헤더를 자동으로 전송하지 않습니다.
애플리케이션이 이미 Fireworks 호출에 대해 OpenTelemetry GenAI span을 발생시키는 경우, 클라이언트를 래핑하는 대신 Amplitude의 OTLP 엔드포인트로 전송할 수 있습니다. 스팬의 gen_ai.response.id은(는) [Agent] Provider Request ID이(가) 됩니다. 에이전트 분석으로 OpenTelemetry 추적 보내기를 참조하십시오.
연동 확인
최소 두 개의 요청이 포함된 대화를 생성한 다음 에이전트 분석을 엽니다. 대화가 하나의 세션으로 표시되고, 각 AI 응답에 [Agent] Provider Request ID 및 [Agent] Model Name이(가) 있는지 확인합니다. 세션은 종료된 후 품질 점수를 표시하며 Amplitude는 이를 보강합니다.
트레이닝할 품질 신호 정의
에이전트 분석(Agent Analytics)은 두 가지 소스에서 각 세션에 레이블을 지정하며, 둘 중 하나가 트레이닝 데이터에서 성공 기준을 정의할 수 있습니다.
- 내장 신호: Amplitude는 모든 종료된 세션에 대해 작업 완료, 응답 품질, 사용자 의도, 세션 안전, 사용자 마찰, 부정적 피드백 및 데이터 품질을 점수로 매기며, 각 점수에는 서면 근거가 제공됩니다. Amplitude는 이러한 신호를 정의하며, 설정이 필요하지 않습니다.
- 사용자 지정 평가자: 내장 정의가 사용자 고유의 작업 완료 버전과 같이 제품과 일치하지 않는 경우 사용자 지정 평가자를 작성하십시오. LLM 평가자는 사용자가 작성한 프롬프트에 응답합니다. 코드 평가기는 패턴을 매칭합니다. 각 평가자는 사용자가 정의한 세트에서 이진 결과 또는 레이블을 반환하며, 사용자가 검토한 세션에 대해 이를 조정합니다. 평가자 생성 및 교정을 참조하십시오.
각 평가기를 실행할 세션을 선택할 수 있습니다: 모든 세션, 샘플링 속도, 또는 도구 오류, 사용자 피드백, 신호 결과와 같은 조건과 일치하는 세션을 선택할 수 있습니다. 평가자가 실행한 세션에만 결과가 포함되므로 교육을 위해 계획하는 세션을 포함하도록 범위를 설정하십시오.
자신의 Fireworks 키 가져오기
사용자 지정 LLM 평가자 및 캘리브레이션 실행은 귀하가 Fireworks에서 제공하는 모델을 사용할 수 있습니다. 조직 관리자가 설정 > AI 컨트롤 > 모델 제공자 아래에 Fireworks API 키를 추가하며, 그런 다음 평가자는 해당 키에 대해 모델 호출을 수행합니다. 사용자 지정 평가자 설정을 참조하십시오.
Fireworks 모델과 현재 모델 비교
모델을 전환하기 전에 현재 모델에 대해 Fireworks 모델을 실험으로 실행하고 Agent Analytics에서 두 모델을 비교하십시오.
- Amplitude 실험과 같이 기능 플래그나 실험을 사용하여 각 사용자를 특정 모델에 할당하십시오.
- 할당된 변형을
experiment_variant로 에이전트의 컨텍스트에 전달하십시오. SDK는 플래그 할당을 읽지 않으므로 변형은 귀하가 전달할 때만 Agent Analytics에 도달합니다. 하위 에이전트는 상위의 컨텍스트를 상속합니다. 컨텍스트를 사용하여 세그멘테이션 추가를 참조하십시오. - 내장 신호, 평가자 결과,
[Agent] Cost USD및[Agent] Latency Ms에 대해 변형을 비교하십시오.[Agent] Context은(는) JSON 문자열이므로 각 변형을[Agent] Context contains "experiment_variant":"<variant>"로 필터링하거나 키를 추출하는 파생 속성을 생성하십시오. Amplitude의 쿼리 컨텍스트를 참조하십시오. - 숫자를 신뢰하기 전에 두 변형의 세션을 모두 읽으십시오.
각 평가자를 두 변형에서 동일한 커버리지로 실행하십시오. 평가자가 세션을 샘플링하거나 일치하는 조건에서만 실행되는 경우, 결과는 모델뿐만 아니라 실행된 세션을 반영합니다. 리텐션과 같은 제품 결과를 위해서는 실험의 분석 보기를 사용하십시오.
고정된 모델 대신 Fireworks 라우터를 호출하는 경우, [Agent] Model Name라우터가 각 응답에 대해 선택한 모델을 기록하므로 동일한 방식으로 라우팅된 모델별로 결과를 비교할 수 있습니다.
점수가 획득된 세션을 내보내어 Fireworks에서 트레이닝
내보내기를 실행하고 트레이닝할 대상을 선택합니다. Amplitude는 세션을 Fireworks로 전송하지 않습니다.
하나의 내보내기 경로를 선택합니다:
- Amplitude에서 데이터 세트 내보내기: 최대 1,000개의 세션으로 구성된 데이터 세트에 세션을 추가하고, 사람이 확인한 타겟을 원하는 곳에 Ground Truth를 지정한 다음 전체 내보내기를 사용합니다. 이 파일에는 모든 세션에 대한 세션 메타데이터, 추적, 보강 및 검토 주석과 태그가 포함됩니다. 데이터 세트를 참조하십시오.
- Export API: HTTP를 통해 세션, 데이터 세트 및 평가자 구성을 파이프라인으로 가져옵니다. 각 세션에는 트레이스와 스팬,
provider_request_id가 포함된 정렬된 턴, 평가자 결과 및 내장 신호가 포함됩니다. 데이터 세트 엔드포인트는 각 멤버의 정답(ground-truth) 레이블을 추가합니다. 플랜의 룩백 창과 세션 상한이 적용됩니다. 에이전트 분석 내보내기 API를 참조하십시오.
Fireworks는 여러 가지 교육 방법을 제공합니다. Fireworks의 교육 요약을 참조하여 하나를 선택합니다. 다음의 두 가지 레시피는 가장 일반적인 경우를 다룹니다.
감독형 미세 튜닝 데이터 준비
감독형 미세 튜닝(Supervised fine-tuning)은 모델에게 좋은 대화를 재현하도록 가르칩니다.
- 기준을 충족하는 세션을 선택합니다. 예를 들어, 작업 완료가 통과되고 부정적 피드백과 사용자 마찰이 감지되지 않았으며, 사용자 지정 평가자가 통과한 세션을 선택하십시오.
- 두 경로 중 하나로 내보냅니다.
- 각 대화를 순서대로 다시 구성하십시오. 내보내기 API에서
turns을(를)created_at(으)로 정렬하고, 각 스팬의raw_input및raw_output에서 메시지 텍스트를 읽으며,shared_attributes에서 시스템 프롬프트 및 도구 정의와 같은 반복되는 값을 해결합니다. - Fireworks 감독형 미세 튜닝에서 예상하는 형식으로,
messages배열을 포함한 대화당 하나의 JSON 객체를 작성하고, 에이전트가 도구를 호출하는 경우tools배열도 포함하십시오.
보상 모델 또는 강화 학습 데이터 준비
보상 모델은 응답에 점수를 매기는 방법을 학습하므로 해당 레이블이 포함된 좋은 예제와 나쁜 예제를 모두 필요로 합니다.
- 통과한 세션뿐만 아니라 전체 결과 범위에 걸쳐 세션을 내보냅니다.
- 모델 요청당 하나의 레코드를 생성합니다. 내장 신호, 평가자 결과 및 ground-truth 레이블에서 해당 시점에 모델의 입력, 출력, 그리고 해당 세션의 레이블을 포함합니다.
- 각 레코드에
provider_request_id을(를) 키로 지정하여 Fireworks가 처리한 요청과 일치시킬 수 있습니다.
Evaluator 결과는 각 평가자가 생성한 대로 도착합니다. 이진 결과에 대해서는 passed 필드를 사용하고, 관심 있는 분류 레이블을 보상에 매핑하십시오. 평가자의 프롬프트에 따라 레이블 세트가 변경될 수 있으므로 인식되지 않는 레이블을 알 수 없는 것으로 처리합니다. 평가 결과를 참조하십시오.
레이블이 지정된 레코드를 사용하여 학습하려면 Fireworks의 Training API를 강화 학습에 사용하거나, 선호도 최적화를 위해 선호 및 거부된 응답 쌍을 구축하십시오.
후보 모델 오프라인으로 테스트
Fireworks 모델을 출시하기 전에 점수를 매기려면 Get an evaluator configuration을 사용하여 평가자 정의를 가져오십시오. 각 구성에는 평가자의 프롬프트, 모델 및 레이블이 포함되어 있으므로 자체 툴링에서 후보 모델의 응답에 대해 동일한 판단을 실행할 수 있습니다.
이 내용이 도움이 되었나요?
For AI agents: a documentation index is available at /docs/llms.txt. Append .md to any page URL for markdown, or send Accept: text/markdown.