Fireworks AIをAgent分析で使用する
エージェント分析は、エージェントがFireworks AIに送信したすべてのリクエストを記録して、各会話の品質をスコアリングします。その後、それらのスコアをユーザーがプロダクト内で行った行動に結びつけます。Amplitude AI SDK for NodeとPythonは、FireworksのOpenAI互換クライアントをラップし、すべてのレスポンスでFireworksのリクエストIDをキャプチャします。 その後、スコアリングされたセッションをエクスポートして、定義した品質基準を使用してFireworksでモデルのトレーニングまたは微調整を行うことができます。
このページは、エージェントがFireworksを直接呼び出す場合に使用します。 FireworksトラフィックがOpenRouterやLiteLLMなどの別のゲートウェイを通過する場合は、代わりにAIゲートウェイとルーターを使用してください。
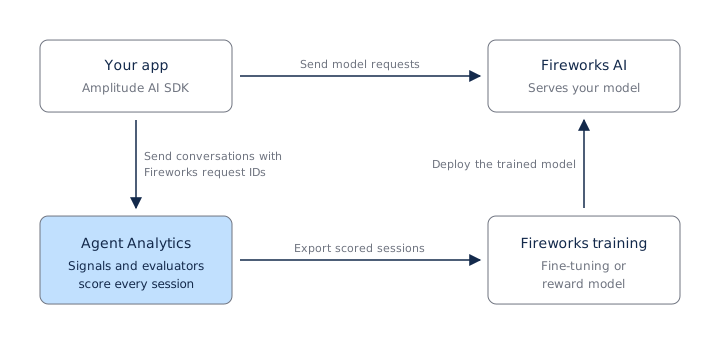
この連携には 3 つの部分があり、次の順序で採用できます。
- Instrument: FireworksクライアントをAI SDKでラップすることで、各リクエストがそのユーザー、会話、エージェント、およびFireworksリクエストIDと共にAgent分析に到達するようにします。
- スコア:Amplitudeの組み込みシグナルは、すべてのクローズされたセッションでスコアを付与します。 カスタム評価ツールは、独自の基準を追加します。
- エクスポート: スコアリングされたセッション、トレース、評価結果をトレーニングパイプラインに取得し、Fireworksでトレーニングします。
AIコーディングエージェントを使用した設定(推奨)
このプロンプトを、Cursor、Claude Code、Windsurf、GitHub Copilot、Codexなどの AI コーディング エージェントに貼り付けます。 エージェントはAI SDKをインストールし、そのバンドルされている手順を読み取り、すべてのFireworks呼び出しを検出して、インストルメントします。
Instrument this app with Amplitude Agent Analytics using the Node SDK. Our model calls go to Fireworks AI.
Also fetch https://raw.githubusercontent.com/amplitude/Amplitude-AI-Node/main/docs/integrations/routers.md
and follow "Path 1: wrap the client" with the Fireworks base URL and the `fireworks` gateway tag.
Install the SDK:
npm install @amplitude/ai @amplitude/analytics-node
Then follow `node_modules/@amplitude/ai/amplitude-ai.md`.
提案された変更を確認し、「連携の検証 (Verify the integration)」を使用して結果を確認します。
FireworksトラフィックをAgent分析に送信する
AI SDKのラップされたOpenAIクライアントをFireworksのベースURL(https://api.fireworks.ai/inference/v1)にポイントし、エージェントセッション内で各リクエストを実行します。セッションは、Fireworksが知らない3つの事実を提供します。つまり、ユーザーの名前、リクエストがどの会話に属しているか、どのエージェントがリクエストを行ったかです。 ラッピングされたクライアントが新しいユーザーメッセージを追跡するため、手動で追跡する必要はありません。
import { AmplitudeAI, OpenAI } from "@amplitude/ai";
const ai = new AmplitudeAI({ apiKey: process.env.AMPLITUDE_AI_API_KEY! });
const fireworks = new OpenAI({
  amplitude: ai,
  apiKey: process.env.FIREWORKS_API_KEY,
  baseUrl: "https://api.fireworks.ai/inference/v1",
});
const agent = ai.agent("support-bot", {
  context: { ingestion_path: "gateway", gateway: "fireworks" },
});
export async function handleChat(
  userId: string,
  sessionId: string,
  messages: { role: "user"; content: string }[],
) {
  return agent.session({ userId, sessionId }).run(async () => {
    const response = await fireworks.chat.completions.create({
      model: "<router or model ID>",
      messages,
    });
    return response.choices[0]?.message.content;
  });
}
SDKは*.fireworks.aiベースURLからFireworksを検出します。各[Agent] AI Responseイベントには、ストリーミングされているかどうかに関係なく、以下が含まれます。
| プロパティ | 値 |
|---|---|
[Agent] Provider | fireworks |
[Agent] Provider Request ID | そのリクエストに対するFireworksのresponse.id。これは、スコアまたはエクスポートされたターンを1つのFireworks推論に結びつけるキーです。 |
[Agent] Model Name | 回答したモデル。ルーターの場合、ルーターが選択したモデルになります。 |
[Agent] Cost USD | 公開料金。 SDKは、ルーターなどの階層ルーターをその階層で、その他のルーターは選択したモデルで-fast価格設定します。 SDKが価格を算出できないモデルは、$0ではなくコストが未設定になります。 |
[Agent] Context | ingestion_pathおよびgateway。このため、チャート上でFireworksのトラフィックをほかのプロバイダーのトラフィックと分離できます。 |
Fireworksが独自のプロキシURLの背後にある場合、SDKはURLからそれを検出できません。 Node SDKでは、クライアントでprovider: 'fireworks'を設定します。SDKはFireworksのx-multi-turn-session-idヘッダーを自動的に送信しません。
アプリケーションでFireworks呼び出しに対してすでにOpenTelemetry GenAIのspanを発行している場合、クライアントをラップするのではなく、AmplitudeのOTLPエンドポイントにこれらのspanを送信できます。スパンのgen_ai.response.idは[Agent] Provider Request IDになります。OpenTelemetryトレースをエージェント分析に送信するを参照してください。
連携を確認する
少なくとも2つのリクエストを含む会話を送信し、Agent 分析を開きます。会話が1つのセッションとして表示されること、および各AIレスポンスに[Agent] Provider Request IDと[Agent] Model Nameがあることを確認します。セッションは、終了後、Amplitudeがセッションをエンリッチした後に品質スコアを表示します。
トレーニングに使用する品質シグナルを定義する
エージェント分析は、2つのソースからセッションにラベルを付けます。また、そのどちらのソースも、トレーニングデータにおける「良好状態」を定義できます。
- 組み込みのシグナル:Amplitudeは、タスク完了、レスポンス品質、ユーザーのインテント、セッションの安全性、ユーザーの摩擦、ネガティブなフィードバック、データ品質について、すべての終了セッションをスコアリングします。それぞれに書面による根拠があります。Amplitudeはこれらのシグナルを定義しており、設定は必要ありません。
- カスタム評価子: 組み込みの定義が、独自のバージョンのタスク完了設定など、プロダクトと一致しない場合は、カスタム評価子を記述してください。 LLM評価者は、あなたが作成したプロンプトに回答します。コード評価器はパターンに一致します。 各評価器は、定義したセットからバイナリ結果またはラベルを返します。この結果は、レビューしたセッションと照合されます。評価器の作成と調整を参照してください。
各評価器が実行するセッションを選択します。すべてのセッション、サンプルレート、またはツールエラー、ユーザーフィードバック、シグナル結果などの条件に一致するセッション。 評価器が実行したセッションのみが結果を保持するため、トレーニングを計画しているセッションを含めるようにカバレッジを設定します。
独自のFireworksキーをご用意ください。
カスタムLLM評価者とキャリブレーション実行では、Fireworks上でホストしているモデルを使用できます。組織の管理者が_「設定」>「AIコントロール」>「モデルプロバイダー」_の下にFireworks APIキーを追加し、評価者がそのキーに基づいてモデル呼び出しを実行します。 カスタム評価者の設定を参照してください。
Fireworksモデルと現在のモデルの比較
モデルを切り替える前に、現在のモデルに対してFireworksモデルを実験として実行し、Agent分析でこの2つを比較します。
- 各ユーザーを、Amplitude実験などで、機能フラグまたは実験を使用してモデルに割り当てます。
- 割り当てられたバリアントを、エージェントのコンテキストの
experiment_variantとして渡します。SDKはフラグの割り当てを読み取らないため、バリアントは渡された場合にのみAgent分析に到達します。 子エージェントは親のコンテキストを継承します。 「コンテキストによるセグメンテーションの追加」を参照してください。 - 組み込みシグナル、評価ツールの結果、
[Agent] Cost USDおよび[Agent] Latency Msのバリアントを比較します。[Agent] ContextバリアントはJSON文字列であるため、[Agent] Context contains "experiment_variant":"<variant>"を使用して各バリアントをフィルタリングするか、キーを抽出する派生プロパティを作成します。Amplitudeのクエリコンテキストを参照してください。 - 数字を信頼する前に、両方のバリアントからセッションを読み取ってください。
比較する各評価器を、両方のバリアントの同じカバレッジで実行します。 評価器がセッションをサンプリングしたり、一致する条件の下でのみ実行したりする場合、その結果はモデルだけでなく、実行されたセッションを反映しています。 リテンションなどのプロダクト結果については、実験の分析ビューを使用します。
固定モデルではなく Fireworks ルーターを呼び出す場合、[Agent] Model Nameシステムはルーターが各レスポンスに対して選択したモデルを記録するため、同じ方法でルーティングされたモデルごとに結果を比較できます。
スコアリングされたセッションをFireworksでのトレーニングにエクスポートする
エクスポートを実行し、トレーニング対象を選択します。 AmplitudeはセッションをFireworksに送信しません。
エクスポートパスを1つ選択します。
- Amplitudeでのデータセットのエクスポート:最大1,000セッションのデータセットにセッションを追加し、人間による検証済みのターゲットが必要な場合はGround Truthとラベルを付け、Full exportを使用します。 このファイルには、セッションのメタデータ、トレース、エンリッチメント、レビューのコメントやタグが保持されます。 データセットを参照してください。
- Export API: HTTP経由でセッション、データセット、評価器の設定をパイプラインにプルします。 各セッションには、そのトレースとスパン、
provider_request_idで順序付けられたターン、評価ツールの結果、および組み込みシグナルが含まれます。データセットエンドポイントは、各メンバーのグラウンドトゥルースラベルを追加します。ご利用のプランのルックバック期間とセッション上限が適用されます。 エージェント分析エクスポート API を参照してください。
Fireworksにはいくつかのトレーニング方法があります。 Fireworksのトレーニング概要を参照して、1つを選択します。 以下の2つのレシピは、最も一般的なケースを対象としています。
教師ありのファインチューニングデータを準備する
教師ありファインチューニングは、モデルに優れた会話を再現するように教えます。
- 基準を満たすセッションを選択します。 たとえば、タスク完了が合格したが、否定的なフィードバックとユーザーの摩擦は検出されず、カスタム評価者は合格したセッション。
- いずれかのパスを使用して、それらをエクスポートします。
- 各会話を順番に再構築します。エクスポートAPIでは、
turnsをcreated_atで並び替え、各スパンのraw_inputおよびraw_outputからメッセージテキストを読み取り、システムプロンプトやツール定義などの繰り返し値をshared_attributesから解決します。 - 会話ごとに
messages配列を持つ1つのJSONオブジェクトを記述し、エージェントがツールを呼び出す場合にはtools配列も含めます。形式は、Fireworksの教師ありファインチューニングが求めるものに従います。
報酬モデルまたは強化学習データを準備します。
報酬モデルはレスポンスのスコアリングを学習するため、このモデルには、ラベル付きの良い例と悪い例の両方が必要です。
- 通過した結果だけでなく、すべての結果範囲にわたってセッションをエクスポートします。
- モデルリクエストごとに1つのレコードを作成します。 組み込みシグナル、評価結果、およびあらゆるGround-truthラベルから、会話におけるその時点でのモデルの入力、出力、およびそれが属するセッションのラベルを含めます。
- 各レコードの
provider_request_idをキーにして、Fireworksが処理したリクエストと照合できるようにします。
各評価者の結果は、各評価者が生成した時点で到着します。 二値の結果にはpassedフィールドを使用し、関心のある分類ラベルを報酬にマップします。認識されていないラベルはunknownとして扱います。これは、評価者のプロンプトによってラベルセットが変更される可能性があるためです。 評価結果を参照してください。
ラベル付きのレコードを使用してトレーニングを行うには、FireworksのTraining APIを強化学習に使用するか、選好最適化のために優先レスポンスと拒否レスポンスのペアを作成します。
候補モデルをオフラインでテストする
Fireworksモデルをリリースする前にスコアリングするには、Get an evaluator configurationを使用して評価者の定義を取得します。各設定には評価者のプロンプト、モデル、ラベルが含まれているため、独自のツールを使用して候補モデルのレスポンスに対して同じ判断を実行できます。
これは役に立ちましたか?
For AI agents: a documentation index is available at /docs/llms.txt. Append .md to any page URL for markdown, or send Accept: text/markdown.